온디바이스 Gemma 스크린샷 분석 파이프라인 구축하기 - 2-pass와 E2B의 한계
Gemma 4 E2B와 E4B에 2-pass 분석을 적용하고, 특수 정보 추출에서 남은 문제를 비교한 기록
이전 글: 온디바이스 Gemma 스크린샷 분석 파이프라인 구축하기 - 모델 설정과 프롬프트 튜닝
출발점: 한 번의 프롬프트로는 부족했다
이전 글에서 Gemma E2B 모델의 출력 일관성을 높이기 위해 여러 가설을 검증했지만, 싱글 프롬프트로 작동하는 파이프라인은 출력 일관성을 완전히 보장할 수 없다는 결론을 내렸다. 이번 글에서는 이 결론을 바탕으로 2-pass 분석 파이프라인을 구축하는 방법을 설명한다.
환경 정보
이전 글과 동일하게 LiteRT-LM을 사용하는 윈도우 환경에서 GPU 가속을 사용해 테스트를 진행했습니다.
- CPU: Intel Core Ultra X7 358H
- GPU: Intel Arc B390
- Memory: 32GB
- OS: Windows 11
- python: 3.12.14
- litert-lm-api: 0.17.1
- jupyter: 1.1.1
- model: Gemma 4 E2B / E4B
기본 모델 설정
- TOP_K = 64
- TOP_P = 0.95
- Temperature = 1.0
- Thinking 비활성화
- Max_Tokens = 2048
- Repetition Penalty = 1.04
- Repetition Penalty Window Size = 64
판단 기준
- 출력이 정해진 형식으로 파싱되는가?
- 필요한 특수 정보를 누락하지 않았는가?
- 불필요한 특수 정보가 포함되지 않았는가?
2-pass 분석 파이프라인 설계
기존 프롬프트에서는 한 번에 제목/본문/특수정보를 추출하도록 했다. 하지만 Gemma 모델이 제목과 본문 뒤에 특수 정보를 정해진 형식으로 출력하라는 지시를 안정적으로 따르지 못했다. 나는 이 구조에서 제목 및 본문 생성과 특수 정보 추출을 별개의 호출로 분리했다.
두 번째 호출은 첫 번째 호출의 출력을 입력으로 받지 않는다. 두 호출 모두 동일한 이미지와 OCR을 읽고 각자의 작업을 독립적으로 수행한다.
1st pass: 제목 및 본문 생성
1
2
3
4
5
6
이미지와 OCR을 읽고 한국어로 답하세요.

반드시 아래 순서를 따르세요.

첫 줄: 구체적인 제목 하나.
다음 줄부터: 핵심 내용을 구체적으로 정리. 마크다운 문법 사용 가능.
출력의 첫 줄을 제목으로, 이후의 줄을 본문으로 처리했다. 다만 이 프롬프트는 마크다운 헤딩도 허용한다. 실제 결과에서 제목 앞에 ##가 붙는 경우가 있어, 첫 줄의 형식이 완전히 안정화된 것은 아니다.
2nd pass: 특수 정보 추출
2nd pass 초기 프롬프트
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
이미지에서의 중요한 실제 값들을 콜론으로 구분하여 한 줄에 하나씩 기록. 각 줄 앞에는 글머리표를 붙이지 않음.
항목은 화면에 맞게 자유롭게 선택하세요. 예시의 항목과 값을 복사하지 마세요.
날짜, 장소, 금액, 번호 등 실제로 확인되는 핵심 값만 최소한으로 기록하고, 해당 값이 없는 항목은 생략하세요.
마지막 줄 다음에는 아무 말도 붙이지 마세요. 구역 제목과 코드 펜스는 쓰지 마세요.
상태표시줄과 사이트 공통 푸터는 제외하세요. 없는 내용을 추측하지 마세요.

마지막 줄들의 작성 예:
상품명: 무선 마우스
가격: 25,000원

다른 화면이라면:
출발일시: 8월 3일 15:00
출발역: 부산
도착역: 서울

다른 화면이라면:
계좌번호: XXXX-XXXX-XXXX
송금 금액: 18,000원
일시: 2026년 8월 4일 16:30
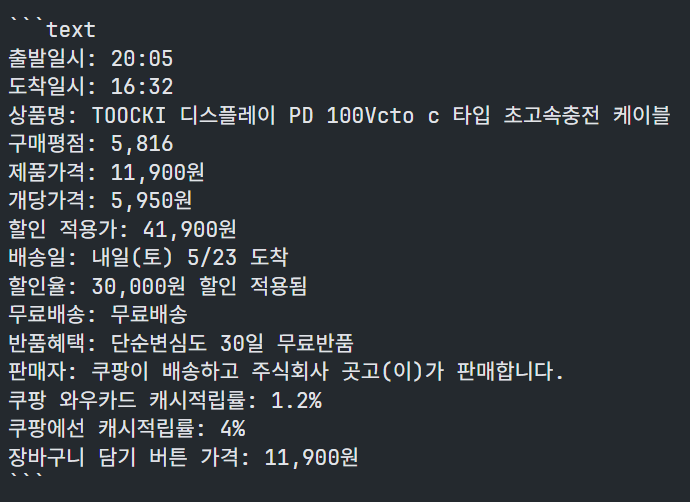
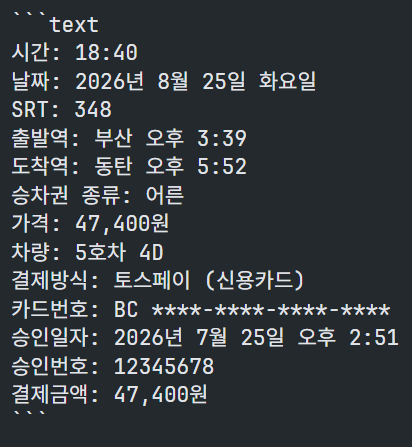
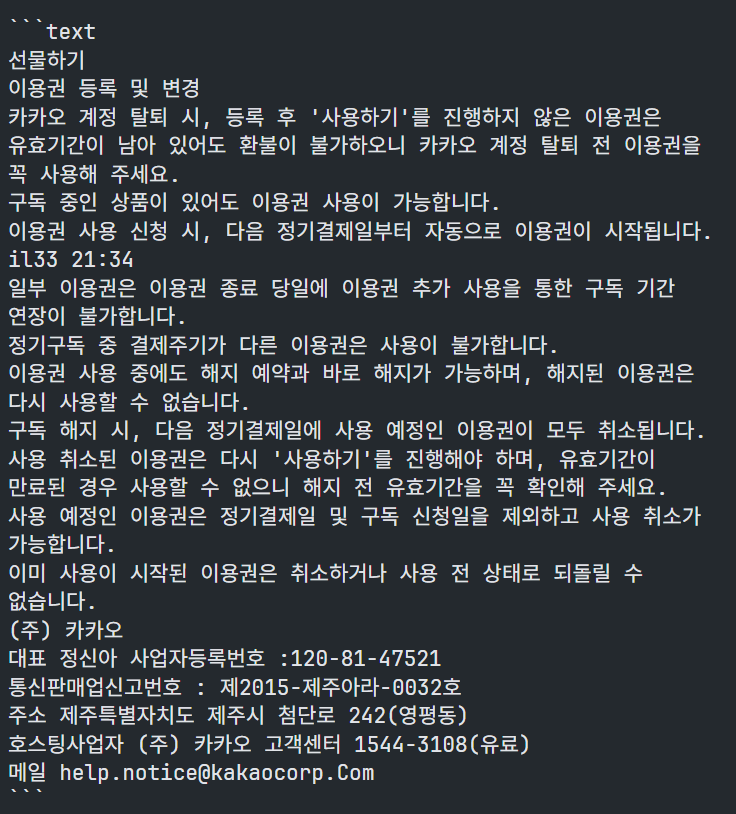
초기 프롬프트의 문제점
- “마크다운 문법 사용 가능”이라는 표현으로 인해 모델이 마크다운 헤딩 및 글머리표를 과도하게 사용하는 문제가 있었다.
- 특수 정보가 없는 경우 중요하지 않은 정보를 가져와 특수 정보로 처리하는 문제가 있었다.
- 불필요한 정보까지 모두 특수 정보로 만들려는 현상이 관찰되었다.
- 특수 정보 출력 세션에서 출력 형식을 지키지 않고 자유롭게 출력하는 현상이 관찰되었다.
테스트에서는 1st pass 프롬프트를 모두 위 버전으로 유지했다. 헤딩 문제는 남아 있지만, 이후 실험은 특수 정보 추출(2nd pass)에 집중했다.
Structured Output으로 형식 강제하기
2nd pass가 제목과 본문을 생성하지 않으므로, 특수 정보가 없는 화면에서는 출력 토큰 수와 시간이 줄어들 것으로 예상했다.
적용 방식과 제약
기존 실험에서 Structured Output은 Speculative Decoding과 충돌했다. Speculative Decoding은 모델 로드 시 설정하므로, 1st pass에서 이를 켜고 2nd pass에서 끄려면 설정이 다른 엔진이 필요했다. 노트북에서는 두 엔진을 동시에 로드해 테스트했다.
모바일 기기에서도 두 엔진을 동시에 유지하기 어렵기 때문에, 여러 이미지를 일괄 1-pass로 처리하고 특수 정보를 추출하는 구조가 가장 적합하다고 생각된다.
초기 실험: 형식과 정보 선택은 별개였다
Structured Output의 Config
Structured Output을 사용하는 2nd pass 프롬프트
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
이미지와 OCR에서 검색, 비교, 기록에 유용한 핵심 사실 데이터만 JSON 배열로 추출하세요.

추출 대상:
- 주요 대상의 명칭 (제목, 상품명 등)
- 정량적 수치 (가격, 금액, 수량 등)
- 시점 및 기간 (날짜, 시간 등)
- 위치 및 장소 (주소, 시설명, 출발/도착지 등)
- 고유 식별 번호 (연락처, 계좌번호, 예약/주문번호 등)

각 항목은 속성명을 키로, 실제 값을 값으로 하는 객체입니다.
예: {"전화번호":"010-1234-5678"}
실제로 확인되는 사실만 넣으세요.
기기 상태표시줄, 사이트 공통 푸터의 회사 정보 등 부가적인 UI 텍스트는 제외합니다.
위 범주에 해당하는 데이터가 없으면 빈 배열 []만 반환하세요.
없는 내용을 추측하지 마세요.
출력 형식
1
2
3
4
5
6
7
8
9
10
11
12
{
    "type": "array",
    "items": {
        "type": "object",
        "properties": {
            "name": {"type": "string", "minLength": 1},
            "value": {"type": "string", "minLength": 1},
        },
        "required": ["name", "value"],
        "additionalProperties": False,
    },
}
초기 기록에서는 2nd pass의 평균이 Structured Output 적용 전 약 4초(출력 150토큰), 적용 후 약 7초(출력 300토큰)였다. 특수 정보 출력을 json 형식에 맞추어 출력하려다 보니 총 출력 토큰 수가 늘어나게 되며 이런 결과로 이어졌다.
JSON 형식을 강제해도 불필요한 정보가 그대로 추출되거나, 추출해야 할 값이 있는데 빈 배열이 나왔다. 출력 형식이 맞는지와 어떤 정보를 선택했는지는 별개의 문제였다.
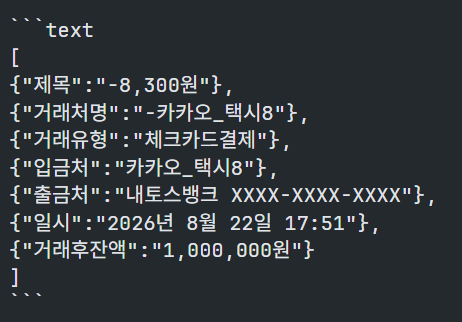
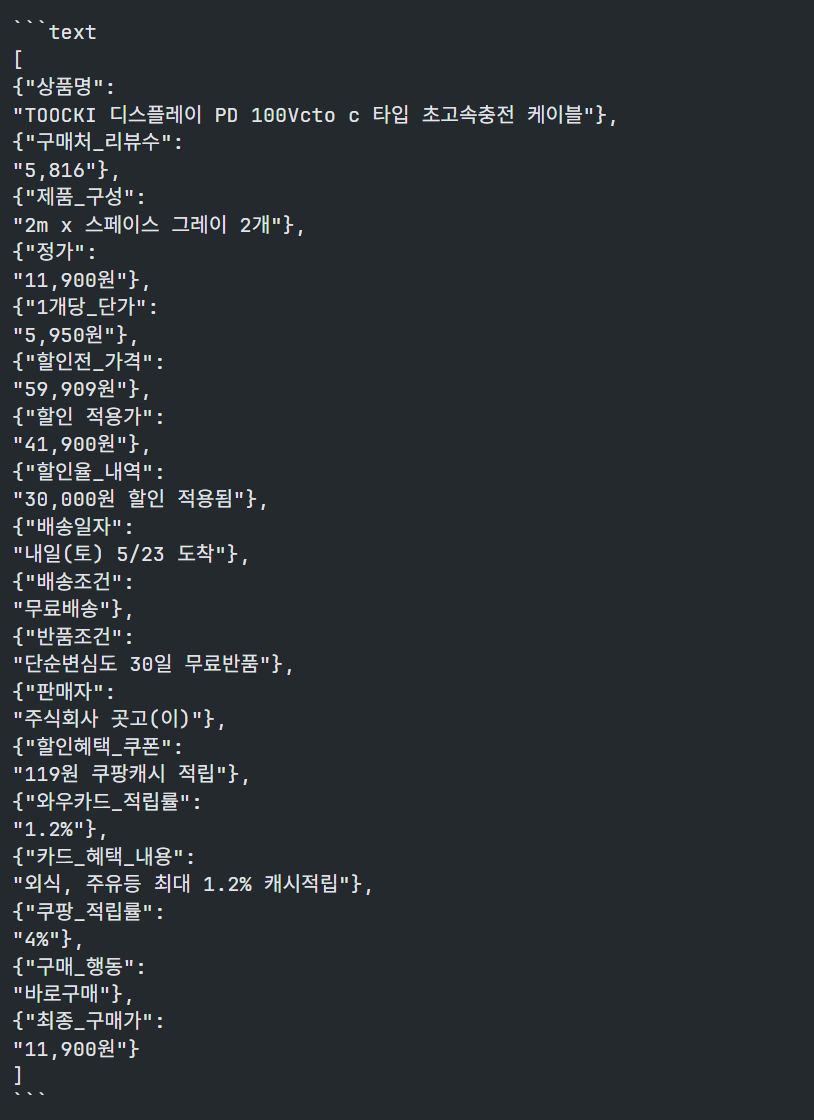
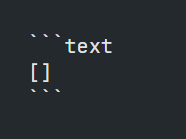
형식 제약만으로 정보 선택 문제를 해결하지 못해, Structured Output을 유지한 채 추출 기준을 다시 정의했다.
특수 정보의 기준 다시 정의하기
기획 당시에는 “특수 정보”라는 것을 시간과 기간, 전화번호, 주소, 금액, 계좌번호 등으로 생각했다. 하지만 어떤 값이 화면의 주된 목적에 필요한지까지 모델에 전달하는 기준은 모호했다.
기존 프롬프트는 항목을 모델이 자유롭게 고르게 했지만, 오히려 이런 방침이 역효과를 준다고 판단해 화면의 주된 일정, 거래, 방문에 직접 필요한 값과 제외할 정보를 더 구체적으로 적어보기로 했다.
수정한 2nd pass 프롬프트 (Structured Output 사용)
1
2
3
4
5
6
7
8
9
10
11
12
13
스크린샷의 핵심 특수 정보만 추출하세요. 제목과 설명문은 다른 단계에서 작성하므로 여기에는 넣지 않습니다.

다음 조건을 모두 만족하는 사실만 남기세요.
1. 화면의 주된 일정, 구매, 결제, 송금, 방문 또는 연락에 직접 관련된다.
2. 날짜·시각·기간, 실제 가격·거래금액, 방문 장소, 계좌·예약·연락 번호처럼 따로 복사하거나 확인할 구체적인 값이다.
3. 이미지나 OCR에 실제 값과 그 의미가 확인된다.

주된 일정의 시작·종료·마감, 실제 판매가·결제금액, 거래일시, 계좌번호는 누락하지 마세요. 0원도 실제 금액입니다. 이름·브랜드·상품 설명·상태·수량·평점·리뷰·제품 사양·적립 및 할부 광고·일반 약관은 본문에 맡기세요. 상태표시줄과 사업자 푸터도 제외합니다.
계좌번호와 카드번호를 혼동하지 마세요. 일정과 무관한 구매일·승인번호를 모두 나열하지 마세요. 현재 가격과 취소선 가격을 구분하세요.
여러 대상의 일시는 대상이 드러나게 이름을 붙입니다. 같은 사실은 한 번만 넣으세요. 핵심 값이 있는 화면에서는 이를 추출하고, 실제로 없을 때만 빈 배열을 반환하세요.
항목명은 의미가 분명한 짧은 한국어로 자유롭게 정하세요. 값은 원문의 숫자·단위·날짜를 보존한 짧은 문자열입니다. 빈 값, 추측, 예시 값은 넣지 마세요. 제공된 JSON 스키마로 결과만 반환하세요.

출력은 JSON 배열입니다. 각 원소는 정확히 두 문자열 필드를 갖습니다. name에는 속성명, value에는 그 실제 값을 넣으세요. 속성명을 JSON 키로 만들지 마세요. 예를 들어 [{"name":"납부기한","value":"12월 5일"}]처럼 작성합니다. 이 예시의 값은 복사하지 마세요. 추출할 정보가 없으면 []입니다.
출력 형식
1
2
3
4
5
6
7
8
9
10
11
12
{
    "type": "array",
    "items": {
        "type": "object",
        "properties": {
            "name": {"type": "string", "minLength": 1},
            "value": {"type": "string", "minLength": 1},
        },
        "required": ["name", "value"],
        "additionalProperties": False,
    },
}
아래 예시에서는 JSON 원문을 읽기 쉽게 name: value 형태로 바꿔 표시했다. 항목을 추가로 선별하거나 수정하지는 않았다.
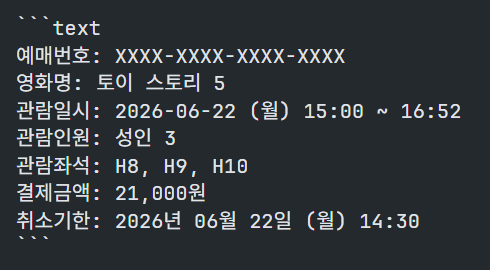
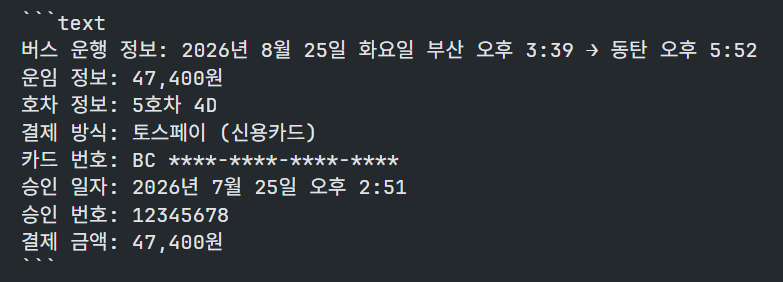
운임 정보와 결제 금액이 중복되는 등의 문제가 있다.테스트 결과, 출력되는 특수 정보의 일관성이 향상됨을 확인할 수 있었다. 하지만, 테스트 이미지 15장 중 6장에서 빈 배열이 나왔다. 그중 4장에는 판매가, 거래금액과 거래일시, 승차 정보, 운영시간과 장소처럼 추출해야 할 값이 있었다. 중요하지 않은 정보를 특수 정보로 판단하는 현상은 줄었지만, 쇼핑 혜택이나 거래 후 잔액이 남은 사례가 있어 프로덕션에서 사용 가능한 수준에는 이르지 못했다.
마지막으로, Structured Output을 사용하지 않고 자유 형식으로 출력하는 방식으로 시도했다. 이에 맞춘 프롬프트를 적용하여 특수 정보를 추출하는 방법을 시도했다.
변경된 2nd pass 프롬프트 (Structured Output 사용 안함)
1
2
3
4
5
6
7
8
9
10
11
12
13
스크린샷의 핵심 특수 정보만 추출하세요. 제목과 설명문은 다른 단계에서 작성하므로 여기에는 넣지 않습니다.

다음 조건을 모두 만족하는 사실만 남기세요.
1. 화면의 주된 일정, 구매, 결제, 송금, 방문 또는 연락에 직접 관련된다.
2. 날짜·시각·기간, 실제 가격·거래금액, 방문 장소, 계좌·예약·연락 번호처럼 따로 복사하거나 확인할 구체적인 값이다.
3. 이미지나 OCR에 실제 값과 그 의미가 확인된다.

주된 일정의 시작·종료·마감, 실제 판매가·결제금액, 거래일시, 계좌번호는 누락하지 마세요. 0원도 실제 금액입니다. 이름·브랜드·상품 설명·상태·수량·평점·리뷰·제품 사양·적립 및 할부 광고·일반 약관은 본문에 맡기세요. 상태표시줄과 사업자 푸터도 제외합니다.
계좌번호와 카드번호를 혼동하지 마세요. 일정과 무관한 구매일·승인번호를 모두 나열하지 마세요. 현재 가격과 취소선 가격을 구분하세요.
여러 대상의 일시는 대상이 드러나게 이름을 붙입니다. 같은 사실은 한 번만 넣으세요. 핵심 값이 있는 화면에서는 이를 추출하고, 실제로 없을 때만 `NULL`을 출력하세요.
항목명은 의미가 분명한 짧은 한국어로 자유롭게 정하세요. 값은 원문의 숫자·단위·날짜를 보존한 짧은 문자열입니다. 빈 값, 추측, 예시 값은 넣지 마세요. 각 줄로 구분된 `name: value` 쌍으로 결과만 반환하세요.

출력은 각 줄마다 `name: value`입니다. name에는 속성명, value에는 그 실제 값을 넣으세요. `name`이나 `value`를 키로 사용하지 마세요. 예를 들어 "납부기한: 12월 5일"처럼 작성합니다. 이 예시의 값은 복사하지 마세요. 추출할 정보가 없으면 `NULL`을 출력하세요.
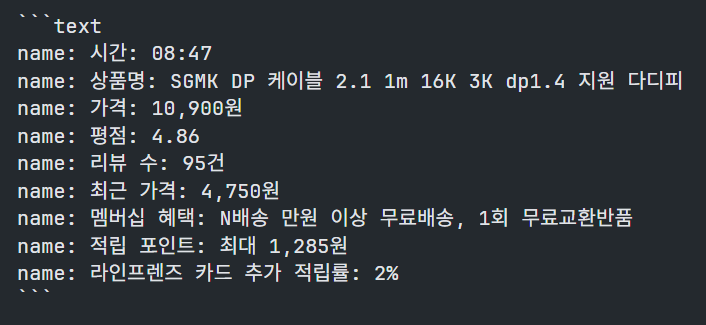 instruction following 실패로 name 출력 | 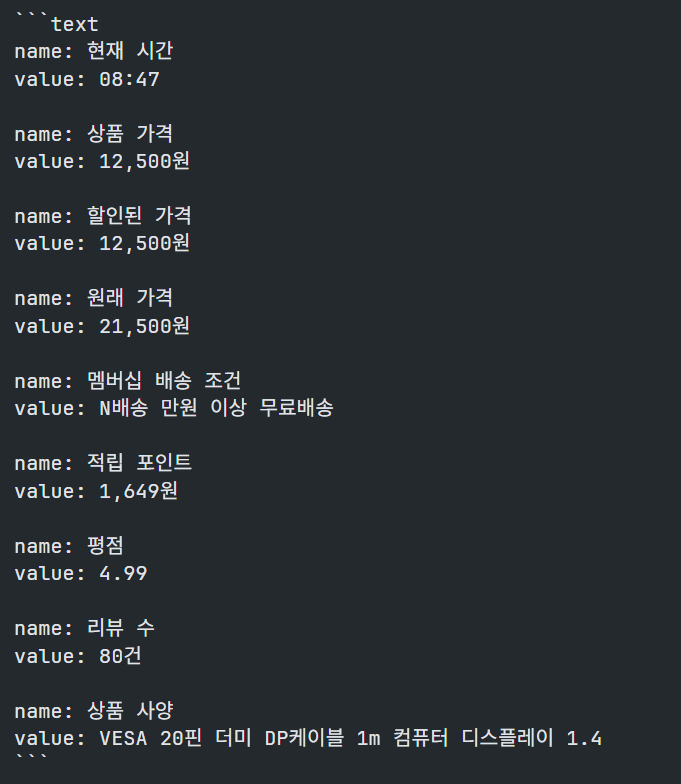 name: value 형식을 따르지 않음 |
이 초기 실행에서는 name과 value를 글자 그대로 출력하거나 name: value 형식을 따르지 않는 문제가 남았다.
E4B에서 다시 확인한 점
E2B에서 형식 이탈과 핵심 값 누락이 반복되어 E4B도 시험했다. 초기 탐색에서는 E4B가 필요한 값을 찾아낸 사례가 있었지만, 일부 성공 사례만으로 안정성을 판단할 수는 없었다. 그래서 두 모델을 같은 15장에 다시 실행해 비교했다.
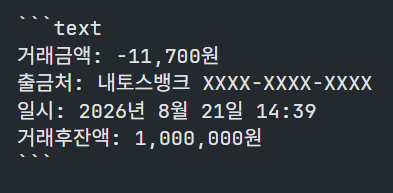 | 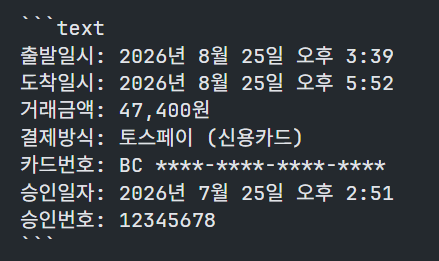 |
| 일부 화면에서 핵심 값을 추출한 E4B 출력 예시 | |
최종 실험: 모델과 출력 방식 비교
같은 15개 스크린샷을 동일 시드로 다시 분석했다. Structured Output 없이 두 pass 모두 Speculative Decoding을 켠 단일 엔진으로 실행했다. Structured Output을 활성화한 테스트에서는 Structured Output을 2nd pass에만 적용하고, Speculative Decoding을 1st pass에서 켜고 2nd pass에서 끈 엔진 두 개를 동시에 로드했다.
각 실행에는 새 Python 커널을 사용하고 모델 캐시를 제거했다. 다만 동일한 15장의 이미지를 사용하였으므로 새로운 실사용 데이터에 대한 검증은 아니다.
| 실행 | 15개 스크린샷의 2nd pass 결과 | 평균 추론 시간¹ |
|---|---|---|
| 59번: E2B, 자유 형식 | 6개 화면에서 name:과 value:를 별도 줄에 그대로 출력. 과다 추출도 많았다 | 2.88초 |
| 60번: E4B, 자유 형식 | 형식은 대체로 개선됐지만 푸터, 잔액, 혜택을 추출하고, 보이지 않는 예매번호에 NULL을 넣었다. | 2.83초 |
| 61번: E2B, Structured Output | JSON 구조 오류는 없었지만, 빈 배열 6건 중 4건은 필요한 값이 있는 화면 | 2.87초 |
| 62번: E4B, Structured Output | E2B에서 잘못 비웠던 4개 화면에서 값을 출력했지만, 1건은 2048토큰 한도에 닿아 불완전한 JSON으로 종료되었다. | 10.67초1 |
1 각 결과 파일에 기록된 15장 평균 2nd pass 추론 시간이며 모델 로드 시간은 제외한다. 한 건의 스크린샷에서 77.77초가 걸렸고 출력 토큰이 2048개였지만, 저장된 텍스트는 짧은 JSON 조각뿐이었다. 원문에서 반복 루프는 확인되지 않았다. 이 건을 제외한 나머지 14장의 평균은 약 5.88초이다.
네 실행에서 사용한 프롬프트를 아래에 정리했다. 같은 출력 방식의 E2B와 E4B는 프롬프트가 동일하므로, 중복되는 원문은 앞선 실행을 참조한다. 이미지와 OCR을 전달할 때 붙인 사용자 메시지는 네 실행 모두 다음 스크린샷을 분석하라.로 시작했다.
E2B/E4B + 자유 형식
1st pass 프롬프트:
1
2
3
4
5
6
이미지와 OCR을 읽고 한국어로 답하세요.

반드시 아래 순서를 따르세요.

첫 줄: 구체적인 제목 하나.
다음 줄부터: 핵심 내용을 구체적으로 정리. 마크다운 문법 사용 가능.
2nd pass 프롬프트:
1
2
3
4
5
6
7
8
9
10
11
12
13
스크린샷의 핵심 특수 정보만 추출하세요. 제목과 설명문은 다른 단계에서 작성하므로 여기에는 넣지 않습니다.

다음 조건을 모두 만족하는 사실만 남기세요.
1. 화면의 주된 일정, 구매, 결제, 송금, 방문 또는 연락에 직접 관련된다.
2. 날짜·시각·기간, 실제 가격·거래금액, 방문 장소, 계좌·예약·연락 번호처럼 따로 복사하거나 확인할 구체적인 값이다.
3. 이미지나 OCR에 실제 값과 그 의미가 확인된다.

주된 일정의 시작·종료·마감, 실제 판매가·결제금액, 거래일시, 계좌번호는 누락하지 마세요. 0원도 실제 금액입니다. 이름·브랜드·상품 설명·상태·수량·평점·리뷰·제품 사양·적립 및 할부 광고·일반 약관은 본문에 맡기세요. 상태표시줄과 사업자 푸터도 제외합니다.
계좌번호와 카드번호를 혼동하지 마세요. 일정과 무관한 구매일·승인번호를 모두 나열하지 마세요. 현재 가격과 취소선 가격을 구분하세요.
여러 대상의 일시는 대상이 드러나게 이름을 붙입니다. 같은 사실은 한 번만 넣으세요. 핵심 값이 있는 화면에서는 이를 추출하고, 실제로 없을 때만 `NULL`을 출력하세요.
항목명은 의미가 분명한 짧은 한국어로 자유롭게 정하세요. 값은 원문의 숫자·단위·날짜를 보존한 짧은 문자열입니다. 빈 값, 추측, 예시 값은 넣지 마세요. 각 줄로 구분된 `name: value` 쌍으로 결과만 반환하세요.

출력은 각 줄마다 `name: value`입니다. name에는 속성명, value에는 그 실제 값을 넣으세요. `name`이나 `value`를 키로 사용하지 마세요. 예를 들어 "납부기한: 12월 5일"처럼 작성합니다. 이 예시의 값은 복사하지 마세요. 추출할 정보가 없으면 `NULL`을 출력하세요.
E2B/E4B + Structured Output
1st pass 프롬프트는 자유 형식 테스트에서 사용한 프롬프트와 동일하다.
2nd pass 프롬프트:
1
2
3
4
5
6
7
8
9
10
11
12
13
스크린샷의 핵심 특수 정보만 추출하세요. 제목과 설명문은 다른 단계에서 작성하므로 여기에는 넣지 않습니다.

다음 조건을 모두 만족하는 사실만 남기세요.
1. 화면의 주된 일정, 구매, 결제, 송금, 방문 또는 연락에 직접 관련된다.
2. 날짜·시각·기간, 실제 가격·거래금액, 방문 장소, 계좌·예약·연락 번호처럼 따로 복사하거나 확인할 구체적인 값이다.
3. 이미지나 OCR에 실제 값과 그 의미가 확인된다.

주된 일정의 시작·종료·마감, 실제 판매가·결제금액, 거래일시, 계좌번호는 누락하지 마세요. 0원도 실제 금액입니다. 이름·브랜드·상품 설명·상태·수량·평점·리뷰·제품 사양·적립 및 할부 광고·일반 약관은 본문에 맡기세요. 상태표시줄과 사업자 푸터도 제외합니다.
계좌번호와 카드번호를 혼동하지 마세요. 일정과 무관한 구매일·승인번호를 모두 나열하지 마세요. 현재 가격과 취소선 가격을 구분하세요.
여러 대상의 일시는 대상이 드러나게 이름을 붙입니다. 같은 사실은 한 번만 넣으세요. 핵심 값이 있는 화면에서는 이를 추출하고, 실제로 없을 때만 빈 배열을 반환하세요.
항목명은 의미가 분명한 짧은 한국어로 자유롭게 정하세요. 값은 원문의 숫자·단위·날짜를 보존한 짧은 문자열입니다. 빈 값, 추측, 예시 값은 넣지 마세요. 제공된 JSON 스키마로 결과만 반환하세요.

출력은 JSON 배열입니다. 각 원소는 정확히 두 문자열 필드를 갖습니다. name에는 속성명, value에는 그 실제 값을 넣으세요. 속성명을 JSON 키로 만들지 마세요. 예를 들어 [{"name":"납부기한","value":"12월 5일"}]처럼 작성합니다. 이 예시의 값은 복사하지 마세요. 추출할 정보가 없으면 []입니다.
출력 스키마는 위의 수정한 2nd pass 프롬프트에 제시한 것과 동일하다.
Structured Output은 E2B 모델에서 발생하는 파싱 문제를 근본적으로 해결해주지만, 테스트 이미지 15장 중 특수 정보로 처리해야 할 이미지 4장을 빈 JSON으로 출력하였다. E4B 모델은 해당 이미지 4개에 대해 값을 추출했지만, 거래 일시나 방문 장소 등 일부 값은 여전히 빠졌다. 공연 화면에서는 예매일을 관람일로 잘못 붙였고, 쇼핑 화면에서는 11,900원과 함께 표시된 41,900원의 역할을 혼동했다. 형식이 맞는 결과에도 정보의 누락과 의미 연결 오류가 남았다.
테스트 실행 중 높은 메모리 압박과 swap도 관찰했다. 새 커널과 캐시 제거로 실행 간 상태를 분리했지만, Structured Output 테스트 중 두 엔진을 동시에 메모리에 유지했고 자유 형식 테스트 중에는 엔진 하나를 사용했다. 출력 길이도 화면마다 달랐다. 따라서 표의 시간만으로 모델 크기나 Structured Output의 속도 영향을 분리할 수 없다고 생각한다. E4B + Structured Output 테스트에서 한 이미지에 대한 긴 실행과 불완전한 JSON이 메모리 압박 때문인지도 이번 기록만으로는 판단할 수 없다.
Memoir의 모델별 기능 지원 기준
Structured Output 비교에서 E4B는 E2B가 잘못 비웠던 4개 화면에서 값을 출력했다. 하지만 E4B에서도 형식 실패와 의미 오류가 발생했다. 따라서 E4B를 특수 정보 기반 Action의 우선 후보로 두되, 이 결과만으로 배포 가능한 신뢰성을 확인했다고 보지는 않는다. E4B 실행 기준은 잠정적으로 RAM 12GB 이상으로 잡고, 8GB 기기에서는 초기 버전의 해당 기능을 비활성화할 계획이다. 실제 모바일 기기의 메모리 사용량과 지연 시간은 별도로 측정해야 한다.
결론: 2-pass만으로는 부족했다
제목 및 본문 생성과 특수 정보 추출을 별도 호출로 나누면서 각 단계의 역할은 분명해졌다. 한 번의 응답에서 여러 형식을 동시에 맞추도록 요구하지 않아도 된다는 점은 이 구조의 장점이다. 다만 1st pass에서는 제목 앞에 마크다운 헤딩이 붙는 사례가 남았고, 역할을 분리한 것만으로 출력의 일관성이 완성되지는 않았다.
더 큰 과제는 2nd pass였다. E2B는 필요한 값을 비우거나 형식을 벗어났고, E4B는 E2B가 놓친 값을 찾아낸 대신 일부 값의 의미를 잘못 연결하거나 불필요한 정보를 포함했다. Structured Output은 JSON 구조를 맞추는 데 도움이 되었지만, 무엇을 추출하고 무엇을 제외할지까지 결정해 주지는 않았다. 형식이 올바른 결과도 실제 화면과 대조해야 하는 이유다.
따라서 이번 결과만으로 특수 정보를 바탕으로 Action을 자동 실행할 만큼의 신뢰성을 확인했다고 보기는 어렵다. 다만 원본 화면과 함께 추출 결과를 보여주고 사용자가 확인+수정하는 참고용 제안이라면 활용 가능성은 있다고 판단했다. 이 판단 역시 이미 살펴본 15장과 한 시드의 결과에 근거하므로, 새로운 화면에서의 누락, 과다 추출, 의미 오류를 다시 평가해야 한다. 모델별 메모리 요구량과 전체 처리 시간도 실제 모바일 기기에서 측정한 뒤 기능 지원 기준을 정할 예정이다.
다음 실험
- 모바일 기기에서 메모리 사용량 및 전체 처리 시간 측정하기
- Gemma가 아닌 다른 모델에서도 테스트해보기
- 모델 미세조정을 통한 출력 품질 향상