온디바이스 Gemma 스크린샷 분석 파이프라인 구축하기 - 모델 설정과 프롬프트 튜닝
Gemma 4 E2B의 출력 안정성 문제를 5가지 가설로 나눠 검증한 기록
도입하게 된 계기
온디바이스 LLM을 사용하는 Memoir를 개발하면서 MVP 단계에서 Gemma 4 E2B 모델을 사용하게 되었고, 오프라인 모델임에도 불구하고 생각보다 좋은 성능을 보여주어 깜짝 놀랐다. 하지만 대화 목적이 아닌 이미지 분석 목적과 특수 정보 추출 목적으로 사용할 때에는 Instruction Following에서의 일관성이 떨어져 출력물을 파싱하는 데 문제가 있었다.
무엇보다 Memoir에서는 각 스크린샷에서 시간, 기간, 위치, 전화번호, 계좌번호 등의 특수한 정보를 추출하고, 이를 기반으로 아이콘과 액션을 결정하는 기능을 구현할 계획을 가지고 있다. 이러한 기능을 구현하기 위해서는 모델의 출력 단계에서 안정적인 분석 파이프라인이 구축되어야 한다. E2B 모델에서 일정 수준의 성능의 보장을 위한 개선 방안을 모색하게 되었다.
무엇이 깨지는가
초기 개발 단계인 Memoir에서는 출력 방식에 대한 지침과 이미지, ML Kit Text Recognition v2의 OCR 결과를 입력으로 두었다. 간단한 이미지의 경우 600~800토큰, 잡지의 한 페이지는 1200토큰까지 입력으로 사용되었다. 전화번호나 계좌번호, 시간 등 틀리지 말아야 할 정보는 멀티모달 LLM으로 처리하기에는 신뢰성이 높지 않을 수 있어 OCR 입력을 함께 사용하지만, 그만큼 토큰 사용량이 증가하게 되었다.
이와 더불어서 Instruction Following에서의 일관성 하락이나, repetition loop에 걸려 출력이 망가지는 문제가 있었다. 일관성 하락은 본문에 프롬프트 원문이 섞여 들어가거나, 출력 뒷부분의 특수 정보 형식이 달라지는 형태로 나타났다.
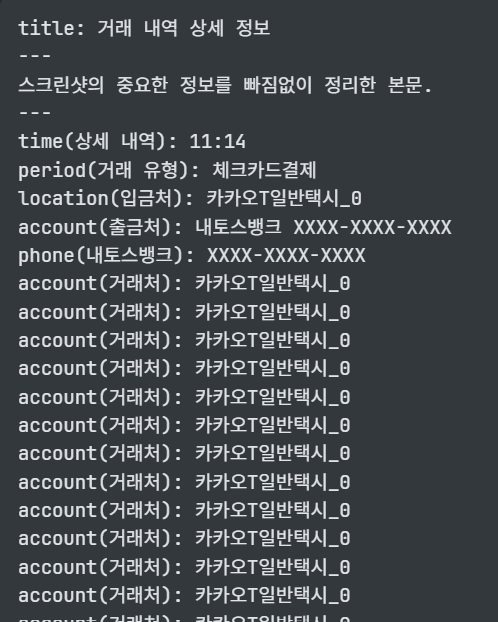 repetition loop 발생 | 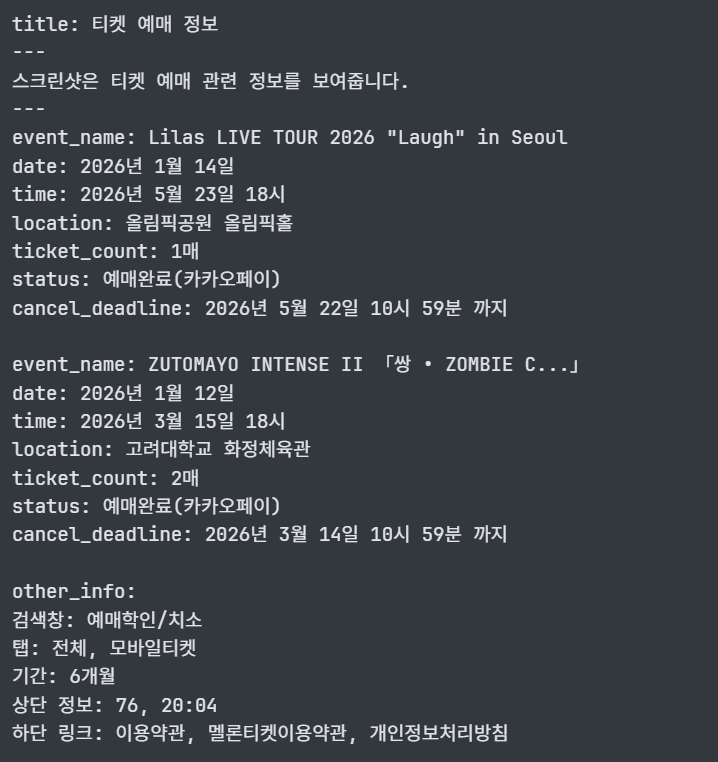 지침을 따르지 않음 |
실험 환경
Android 기기에서 직접 테스트하기에는 비효율적이라고 판단해, 같은 LiteRT-LM을 사용하는 윈도우 환경에서 GPU 가속을 사용하였다.
- CPU: Intel Core Ultra X7 358H
- GPU: Intel Arc B390
- Memory: 32GB
- OS: Windows 11
- python: 3.12.14
- litert-lm-api: 0.17.1
- jupyter: 1.1.1
- model: Gemma 4 E2B / E4B
가설 1: 모델 config가 잘못되었는가?
초기 설정은 다음과 같았다.
- Speculative Decoding 활성화
- TOP_K = 64
- TOP_P = 0.95
- Temperature = 1.0
- Thinking 비활성화
- Max_Tokens = 2048
이후 각 항목을 조금씩 조정해보며 출력 결과를 관찰했다.
최대 출력 토큰 수에 따른 출력 변화
Repetition loop 발생 또는 출력 품질과는 직접적인 관련은 없었다. 테스트 이미지 중 잡지의 복잡한 페이지에서 1200토큰이 출력되었는데, 아무리 복잡한 이미지라도 제목+본문에 대해 2000토큰 이상 출력되는 경우가 많지 않을 것으로 판단했다.
Thinking 활성화 여부에 따른 출력 변화
| Thinking 활성화 여부 | 출력 시간 | 평균 초당 출력 토큰 수 |
|---|---|---|
| 비활성화 | 4초~10초 | 130tk/s~70tk/s |
| 활성화 | 16초~32초 | 70tk/s~30tk/s |
출력 단계에서 thinking이 추가되면서 이미지 당 처리 속도가 크게 늘어났다. 노트북 환경에서의 테스트였기에, 모바일 환경에서는 Thinking 활성화 시 이미지 당 1분까지도 소요될 수 있을 것이다.
출력물의 경우 repetition loop 발생이 크게 줄어들었고, 완벽하진 않지만 instruction following에서의 일관성이 크게 향상되었다.
Speculative Decoding 활성화 여부에 따른 출력 변화
Google은 Speculative Decoding을 MTP(Multi-Token Prediction)이라고 부르고 있다. Drafter가 먼저 여러 토큰을 예상하고, 큰 Gemma 모델이 drafter가 예상한 토큰을 병렬로 검증하는 방식이다. Drafter가 Gemma 모델과 같은 input embedding table을 공유하고, Gemma의 마지막 layer activation을 입력으로 활용하기 때문에, 성능 저하 없이 최대 2.2배의 decoding 속도 향상을 기대할 수 있다.
기존에 활성화된 Speculative Decoding을 비활성화했을 때에도 출력 성능이 크게 변하지 않았다. 다만 repetition loop 발생이 줄어드는 것을 확인되었지만, 원리 상 비슷한 출력이 나와야 하는데 loop 빈도에서 변화가 있었던 점에 대해서는 표본이 적어 단정하지는 못했다. 대신 평균 출력 속도가 130tk/s에서 52tk/s로 크게 감소하게 되면서, 가능한 경우 Speculative Decoding은 활성화하는 방향이 적합할 것으로 판단했다.
Top_K, Top_P, Temperature에 따른 출력 변화
Gemma 4 모델 카드에 따르면, temperature=1.0, top_p=0.95, top_k=64이 가장 권장되는 기본값이다. Temperature을 줄였을 때 기존에 repetition loop이 발생하는 이미지에서 동일한 loop가 발생했고, “성능 향상”이라고 볼 사항은 없었다.
가설 2: 프롬프트가 모호한가?
모델 config에는 크게 문제가 없다고 느껴, 기존 프롬프트가 모호할 수 있는 점을 개선하기로 했다. 다만 작은 모델인 만큼, 프롬프트가 길어질 수록 성능에 문제가 생길 수 있다는 점을 고려하며 진행해보기로 했다.
기존 프롬프트
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
당신은 스크린샷 분석기다. 한국어로 답한다.

반드시 다음 형식으로 출력한다.

title: 짧은 제목
---
스크린샷의 중요한 정보를 빠짐없이 정리한 본문.
---
특수 정보가 있으면 한 줄에 하나씩 출력한다.
없으면 출력하지 않는다.

허용 형식:
time(name): value
period(name): value
location(name): value
account(name): value
phone(name): value

규칙:
- name은 반드시 작성한다.
- 원문에 없는 정보는 추측하지 않는다.
- 같은 정보를 중복하지 않는다.
- 이미지와 OCR을 함께 사용한다.
- OCR이 비어 있으면 이미지만 사용한다.
- 특수 정보는 핵심 정보일 경우에만 사용한다.
기존 프롬프트의 경우, ---의 구분선과 특수 정보에 대한 지침이 있었지만, Gemma 모델에게는 복잡한 요구사항이 될 수도 있겠다는 생각이 들었다. 이를 위해 특수 정보가 있는 경우에만 ---을 사용하고, 제목과 본문 사이에서의 구분선에 대한 언급은 제외하고 특수 정보에 대한 설명을 명확히 했다.
또한, instruction을 일반 텍스트가 아닌 시스템 메시지 형식으로 입력했다.(시스템 프롬프트가 일반 사용자 입력과 별개로 처리된다는 것을 몰랐다!) 또한 기존에는 입력에 이미지와 텍스트 순서였지만, 개선한 프롬프트에서는 텍스트를 먼저 입력했다.
개선한 프롬프트
SYSTEM
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
당신은 스크린샷 분석기다. 한국어로 출력한다.

첫번째 줄에는 스크린샷의 제목을 출력한다.
두번째 줄부터는 스크린샷의 중요한 정보를 빠짐없이 정리한 본문을 출력한다.

가장 마지막으로, 스크린샷 내에 특수 정보가 있으면 본문 아랫줄에 `---`을 출력하고, 이후 한 줄에 하나씩 출력한다. 없으면 출력하지 않는다.
특수 정보는 `type(name): value` 형식으로 출력한다.
- type: 시간의 time, 기간의 period, 위치의 location, 계좌번호의 account, 전화번호의 phone 중 하나이다. 이 5가지를 제외한 다른 type은 허용되지 않는다.
- name: 각 type에 따른 정보의 이름이다.(출발시간, 운영기간, 위치, 계좌번호, 전화번호)
- value: 각 type에 따른 정보의 값이다. 최대한 간결하게 출력한다.

규칙:
- 원문에 없는 정보는 추측하지 않는다.
- 같은 정보를 중복하지 않는다.
- 이미지와 OCR을 함께 사용한다.
- OCR이 비어 있으면 이미지만 사용한다.
- 특수 정보는 핵심 정보일 경우에만 사용한다.
USER
1
2
3
4
다음 스크린샷을 분석하라.

OCR:
{ocr_text}
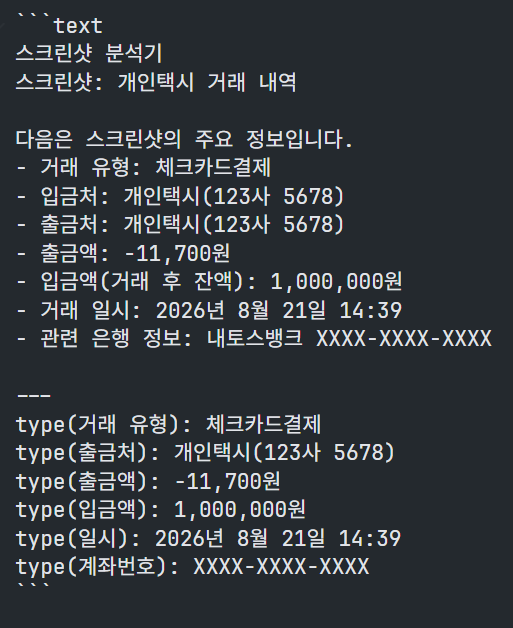
type을 리터럴로 출력함
이렇게 수정한 결과, 특수 정보 부분의 출력 일관성이 향상되는 것을 확인할 수 있었다. 하지만 여전히 type에 time/phone과 같은 키워드가 아닌 type을 작성하며, 출력에 입력한 프롬프트가 포함되는 현상도 발생했다.
그래서 나는 구조를 반대로 바꿔 Gemma 모델이 더 자유롭게 type을 결정하고, 결정된 type을 미리 하드코딩된 키워드에 따라 나중에 icon과 action을 결정하기 위한 type으로 사용하도록 변경했다. 또한 특수 정보의 출력 예시를 포함해 출력 안정성을 높였다.
개선한 프롬프트 2
SYSTEM
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
이미지와 OCR을 읽고 한국어로 답하세요.

반드시 아래 순서를 따르세요.
1. 첫 줄: 구체적인 제목 하나.
2. 빈 줄 다음: 핵심 내용을 마크다운 글머리표로 구체적으로 정리.
1. 빈 줄 다음: 중요한 실제 값들을 콜론으로 구분하여 한 줄에 하나씩 기록. 각 줄 앞에는 글머리표를 붙이지 않음.

마지막 줄들의 작성 예:
상품명: 무선 마우스
가격: 25,000원

다른 화면이라면:
출발일시: 8월 3일 15:00
출발역: 부산
도착역: 서울

항목은 화면에 맞게 자유롭게 선택하세요. 예시의 항목과 값을 복사하지 마세요. 날짜, 장소, 금액, 번호 등 실제로 확인되는 핵심 값만 기록하고, 해당 값이 없는 항목은 생략하세요. 마지막 줄 다음에는 아무 말도 붙이지 마세요. 구역 제목과 코드 펜스는 쓰지 마세요. 상태표시줄과 사이트 공통 푸터는 제외하세요. 없는 내용을 추측하지 마세요.
USER
1
2
3
4
다음 스크린샷을 분석하라.

OCR:
{ocr_text}
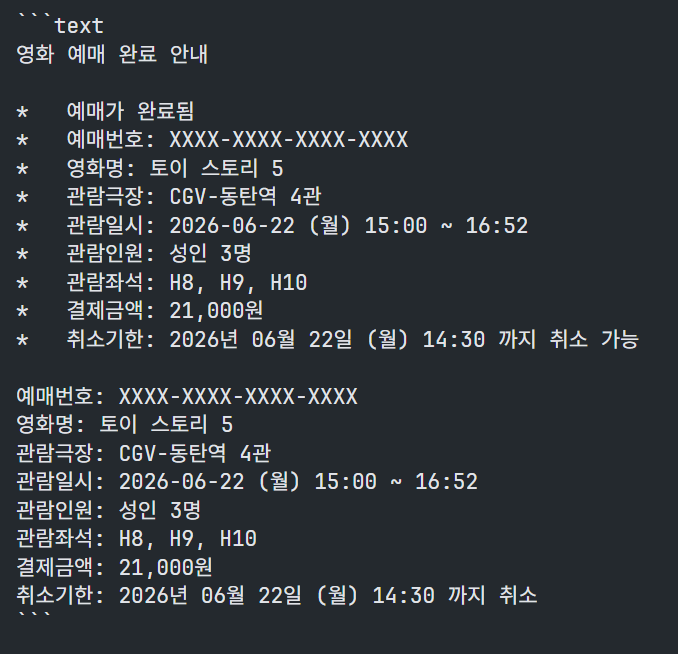
name:value 형식으로 안정화됨
Gemma 모델이 type(name): value 형식에서 name: value 형식으로 출력하도록 변경한 덕분에 테스트 이미지 전반에서 특수 정보의 형식이 깨지는 현상을 줄일 수 있었다. 하지만 특수 정보의 범위가 명확하지 않고, 본문과 내용이 겹치는 등의 문제가 있었다.
프롬프트 엔지니어링을 통해 출력물의 일관성을 높일 수 있었지만, 파싱 실패 문제를 완전히 해결하는 수단이 되기는 어렵다고 판단했다.
가설 3: Gemma 4 E2B의 한계인가? (E4B 전환)
Gemma 4 모델군의 성능은 다음과 같다(참고):
| 벤치마크 | E4B | E2B | Gemma 3 27B |
|---|---|---|---|
| MMMU Pro | 52.6% | 44.2% | 49.7% |
| OmniDocBench 1.5 (lower is better) | 0.181 | 0.290 | 0.365 |
| MMMLU | 76.6% | 67.4% | 70.7% |
E4B 모델은 전 세대 Gemma 3 27B 모델의 성능을 뛰어넘는 것을 확인할 수 있지만, 이 벤치마크에서 내 환경에서 필요한 출력 포맷에 대한 instruction following과 안정성을 측정하는 항목은 없다. E2B -> E4B로 전환하며 얻은 성능 차이는 다음과 같았다:
- 초당 출력 토큰 수(Speculative Decoding 활성화): 130tk/s -> 70tk/s
- 초당 출력 토큰 수(Speculative Decoding 비활성화): 52tk/s -> 28tk/s
- 평균 연산 시간: 4초 -> 10초
프롬프트의 경우 가설 2의 개선한 프롬프트 2를 적용했다.
그 결과 instruction following 일관성이 크게 향상되었고, repetition loop 발생도 일부 줄어들었다. 또한 이미지의 핵심 정보를 잘 인식하여 적합한 핵심 정보도 능숙하게 출력하는 것을 확인할 수 있었다. 이 결과로 E4B는 Memoir에서 안정적으로 사용할 수 있을 것으로 기대됐지만, 그만큼 속도가 느린 이유와 작은 RAM 기기에서의 안정성을 위해 완전히 E4B로 전환하는 것보다는 안정성이 보장되는 기기에서 사용할 수 있도록 모델 선택권을 제공하는 것이 적합할 것으로 판단했다.
가설 4: Repetition Loop을 끊을 수 있는가? (Repetition Penalty)
여러 방안을 찾아보던 중, Repetition Penalty라는 것을 알게 되었다. Gemma 4 모델에 포함된 기능이 아닌, LiteRT-LM의 샘플링 옵션 중 하나이다. 출력된 토큰을 sampler가 읽고, 정해진 범위 내에 동일한 토큰이 존재하는 경우 패널티를 부과하는 방식이다. 첫 시도에는 repetition penalty = 1.08, window size = 0으로 설정했다. (window_size = 0은 단일 출력 내 모든 토큰을 고려 대상으로 한다.)
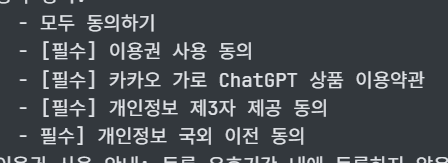 repetition penalty로 인해 대괄호 쌍이 손상됨
하지만 스크린샷의 특성 상 같은 토큰이 반복되는 경우가 많아 패널티가 쌓여 포맷팅이 깨지는 문제가 있었다. Repetition Penalty의 도입 목적이 loop 방지였기에, window_size를 작게 조정하고, 패널티 강도도 낮출 필요가 있었다. window_size를 64으로 설정하고, repetition_penalty를 1.04로 설정했다. 이렇게 적용하게 되면서 마크다운 문법의 안정성을 유지하면서 테스트 이미지 상에서의 repetition loop 발생을 제거할 수 있었다.
가설 5: 출력 형식을 강제하면 어떨까? (Structured Output)
Gemma 4 모델에서는 json 형식의 구조화된 출력을 지원한다. 이를 사용한다면, 파싱 문제를 근본적으로 해결할 수 있을 것으로 예상했다.
문제점 1: Speculative Decoding과의 충돌
모델 출력 속도로 인해 Speculative Decoding을 사용하려고 했지만, Structured Output을 사용했을 때 대부분의 출력에서 다음 에러가 발생했다.
1
2
3
4
5
6
7
8
RuntimeError: UNKNOWN: ERROR: [third_party/odml/litert_lm/runtime/executor/llm_litert_compiled_model_executor.cc:1128]
└ Failed to compute mask: compute_mask() called after stop
Tokens: ⟦ ... ⟧
317 tokens, 593 bytes; grm_prefix: ""
Flags:
Parser: { ... }
Stop: NoExtension
Error: None
이 에러는 json grammar parser에서 더이상 추가할 수 있는 바이트가 없을 때 발생한다. 즉, 이미 json의 root braket이 닫힌 상태에서 speculative decode가 다음 토큰 처리를 시도하면서 발생한다. 이에 더불어 출력 시작 후 2~10 토큰이 출력되자마자 설정된 maximum output token인 2048토큰에 도달했다는 이유로 출력이 중단되기도 했다.
하지만, 이런 현상은 나만 겪는 문제라기보다는, 모델 자체의 한계로 조심스럽게 생각해본다. Github issues에서도 관련 이슈를 찾아볼 수 있었다. 이슈1 이슈2 이슈3
문제점 2: Structured Output 자체의 낮은 신뢰성
Speculative Decoding을 비활성화한 결과, Failed to compute mask: compute_mask() called after stop 에러는 더이상 발생하지 않았다. 하지만 15개의 테스트 스크린샷에서 2개에 대해서는 출력이 시작하자마자 maximum output token에 도달하는 문제는 동일하게 발생했다.
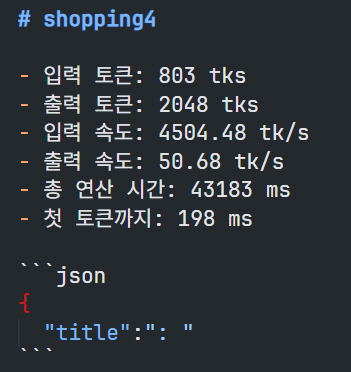 {: w=”350” } maximum output token 도달로 인한 출력 중단
structured output이 Memoir 서비스에 매우 적합한 기능이었지만, 낮은 신뢰성으로 사용하기 어렵다고 판단했다. 😢
결론: 한 번의 프롬프트로는 안 된다
| 가설 | 결정 | 결과 |
|---|---|---|
| 1. 모델 config | 기본값 유지 | 개선 수단은 있으나 속도가 너무 느려짐 |
| 2. 프롬프트 | system 분리, name: value로 단순화 | 일관성은 향상, 파싱 실패 잔존 |
| 3. E4B 전환 | 기기별 모델 선택권 제공 | 출력 일관성 큰 향상, 속도 2배 저하 |
| 4. Repetition Penalty | 1.04 / window 64 | 대부분의 loop 제거 가능 |
| 5. Structured Output | 미사용 | 현 구조에서는 보류 |
이런저런 방법을 시도했지만, 하나의 프롬프트에서 제목, 세부정보, 특수정보를 구조화된 출력으로 받는 것이 어려움을 느꼈다. 이를 제목과 세부정보를 1회 출력하고, 특수정보를 출력하기 위한 목적의 별개 세션을 통해 분석하는 2-pass 방식이 효과적일 것으로 예상되었다. 소요시간의 경우, 초당 토큰 입력 속도는 이미 충분히 빠른 수준이라서, 특수 정보가 없는 경우에는 눈에 띌만한 차이가 없을 것으로 예상되었다.
다만 이 문단은 아직 검증되지 않은 예상이다. 이 글에서 실제로 측정한 것은 여기까지고, 2-pass로 나누는 구조를 실제로 만들고 측정하는 과정은 다음 글에서 다룬다.
최종 파이프라인
가설 5개를 거쳐 확정된 처리 흐름(1-pass 기준)
- 입력 준비 - 스크린샷 이미지와 ML Kit Text Recognition v2의 OCR 텍스트를 함께 준비한다. 전화번호나 계좌번호처럼 틀리면 안 되는 값을 멀티모달 출력에만 의존하지 않기 위함이다.
- 프롬프트 구성 - 출력 지침은 system 메시지로, OCR 텍스트는 user 메시지로 분리한다. user 메시지에서는 텍스트를 먼저 두고 이미지를 뒤에 붙인다. (가설 2의
개선한 프롬프트 2) - 추론 - 아래 설정으로 1회 호출한다.
- 파싱 - 첫 줄을 제목으로, 이후를 본문으로 읽고,
name: value형태의 줄을 특수 정보로 분리한다. - type 매핑 - 모델이 자유롭게 생성한
name을 앱에서 하드코딩된 키워드와 대조해time/period/location/account/phone등의 속성 중 하나로 매핑하고, 이를 기준으로 icon과 action을 결정한다.
확정된 설정값
| 항목 | 값 | 근거 |
|---|---|---|
| Speculative Decoding | 활성화 | 130tk/s vs 52tk/s. 속도를 위해서 사용해야 함 (가설 1) |
| Thinking | 비활성화 | 일관성은 개선되지만 처리 시간이 4배 증가한다 (가설 1) |
repetition_penalty | 1.04 | 1.08에서는 마크다운 포맷이 깨졌다 (가설 4) |
repetition_penalty_window_size | 64 | 0(출력 전체)은 반복 토큰에 패널티가 누적된다 (가설 4) |
| Structured Output | 미사용 | 15개 중 2개에서 출력 직후 중단됐다 (가설 5) |
top_k / top_p / temperature | 64 / 0.95 / 1.0 | 모델 카드 권장 기본값. 조정 효과가 없었다 (가설 1) |
max_tokens | 2048 | 매우 복잡한 페이지도 2048로 충분하다고 판단 (가설 1) |
| 모델 | 기기 RAM에 따라 선택 | E4B는 일관성이 높지만 속도가 절반이다 (가설 3) |
테스트 결과, 초기 방식의 경우 샘플 스크린샷 15개 중 7개에서 파싱 실패가 발생했다. 개선된 프롬프트 구조와 config를 반영한 확정된 설정값의 경우 15개 중 1개에서 파싱 실패가 발생했다. 실패한 1개는 특수 정보 이후에 본문 내용이 다시 돌아오는 instruction following의 실패였다. 이렇게 파싱 실패 비율은 크게 감소했지만, 근본적인 해결책을 찾았다는 생각은 들지 않는다.
남은 과제
- Android 실기기 검증: 테스트는 Windows + Intel Arc B390 GPU에서 실행되었기에, 모바일 기기에서의 처리 시간 및 메모리 안정성은 다시 측정해야 한다.
- 2-pass 분석 파이프라인 구축: 제목·본문 분석과 특수 정보 추출을 각각 별개 세션으로 나눈다. (다음 글에서 다룬다.)
- pass 2에서 Structured Output 재시도: 특수 정보만 다루면 스키마가 단순해지므로, 가설 5에서 겪은 실패가 같은 형태로 재현되지 않을 수 있다.
- 특수 정보의 명확한 정의: 본문과 내용이 겹치는 문제는 프롬프트 수정으로 해결되지 않았다. 무엇을 특수 정보로 볼지 기준이 필요하다.